Speech-to-Text System
Prototype speech-to-text end-to-end untuk bahasa Inggris yang mengubah audio dan video menjadi transkrip, subtitle SRT, serta video dengan subtitle tertanam.
Galeri Proyek
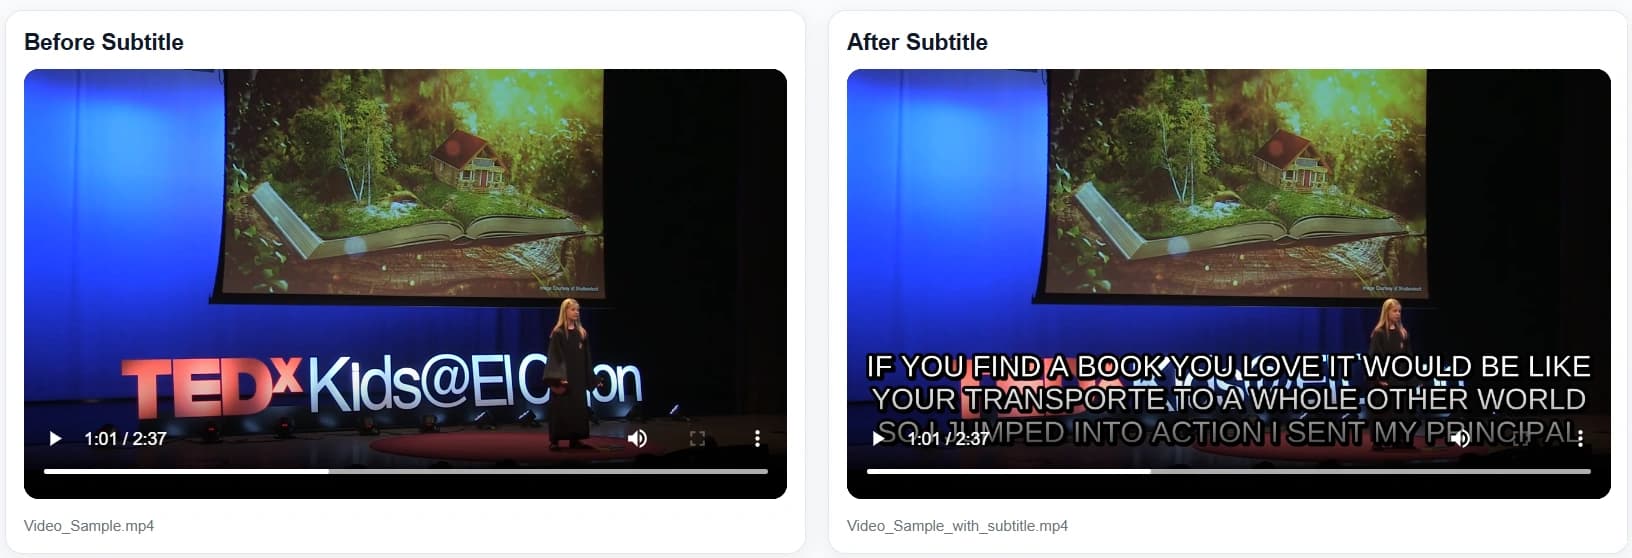
Gambaran Proyek
Workflow ini dikembangkan di Google Colab dan menerima input audio WAV dan MP3 atau video MP4. Audio dari video diekstrak menggunakan FFmpeg, dikonversi menjadi mono 16 kHz, lalu dibagi menjadi beberapa chunk sebelum proses transkripsi.
Setiap audio chunk diproses menggunakan pretrained model facebook/wav2vec2-base-960h melalui Hugging Face Transformers. Hasilnya dapat diekspor sebagai file TXT, CSV, JSON, dan SRT atau ditanamkan langsung ke video akhir.
Kontribusi Saya
- Membangun workflow input untuk audio WAV dan MP3 serta video MP4, termasuk proses ekstraksi audio dari video menggunakan FFmpeg.
- Mengimplementasikan konversi audio menjadi mono 16 kHz dan pemrosesan berbasis chunk untuk menyiapkan audio berdurasi panjang sebelum inference bertahap.
- Mengintegrasikan pretrained model Wav2Vec2 melalui Hugging Face Transformers dan menyusun hasil transkripsi dalam format TXT, CSV, dan JSON.
- Menghasilkan subtitle SRT berdasarkan timestamp dan menggunakan FFmpeg untuk menanamkannya ke video akhir.
Project ini memberi saya pengalaman menggabungkan pretrained machine learning model dengan workflow pemrosesan audio dan video secara end-to-end.
- Python
- Wav2Vec2
- Hugging Face Transformers
- Librosa
- FFmpeg
- Google Colab
Cakupan Sistem
- Input audio WAV dan MP3
- Input video MP4
- Ekstraksi audio dari video dengan FFmpeg
- Konversi mono 16 kHz
- Pemrosesan berbasis chunk untuk audio panjang
- Transkripsi bahasa Inggris saja
- Pretrained model facebook/wav2vec2-base-960h
- Eksekusi model melalui Hugging Face Transformers
- Inference bertahap untuk chunk audio
- Tanpa custom fine-tuning
- Tanpa benchmark WER atau CER
- Transkrip TXT
- Transkrip CSV
- Transkrip JSON
- Subtitle SRT berbasis timestamp
- Video dengan subtitle tertanam
- Bukti visual perbandingan sebelum dan sesudah